表格竞赛 · EDA
01|竞赛 EDA:用漂移和泄漏诊断决定下一步
从预测时点出发检查样本粒度、重复实体、缺失与训练测试漂移。用反证实验区分真实信号和评测捷径。
章节 · 数据与验证
登录后可保存进度和领取学习积分。
目标:在第一轮建模前,交付一张数据审计表和三个优先实验。贯穿示例为下单时预测未来 7 天是否退款,样本粒度是一笔订单,预测时点为下单时刻 t₀。
01|先查「这一行是什么」
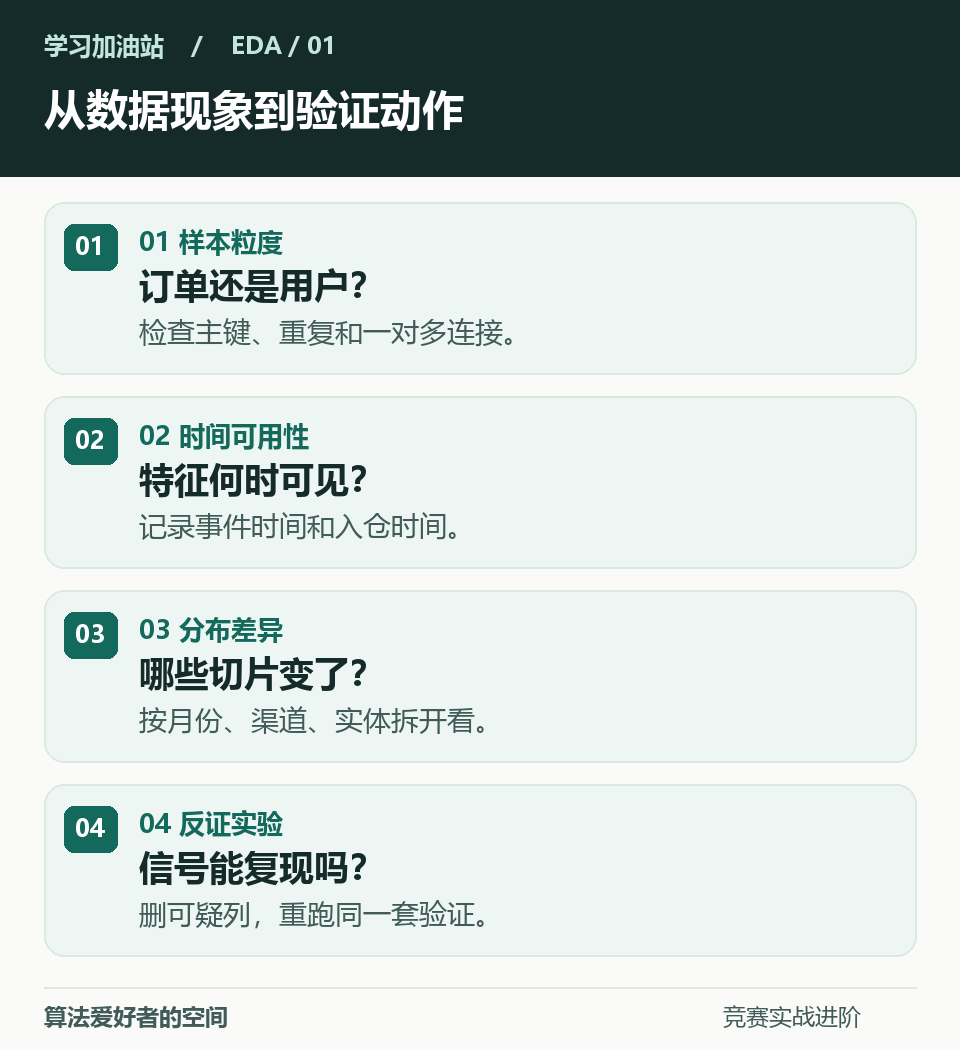
核对原始行数、order_id 唯一性、每用户订单数、标签覆盖率和连接前后行数。拼接明细时先在子表按订单聚合,再验证连接基数;同一个标签被复制成十行会给频繁用户过高权重。分别记录用户跨训练/测试的重叠率、完全重复率和重复但标签冲突的样本。不要把重复都删掉:真实多次订单与数据回灌产生的重复是两回事。
02|缺失和漂移要落到可执行假设
给每列记训练/测试的缺失率、唯一值数、分位数和未知类别率;按月与渠道再算一遍,避免均值掩盖局部变化。数值可用固定训练分位点分桶比对,空值单独成桶。用只看 t₀ 可见特征的分类器预测「来自训练还是测试」,对它做分组或按时间验证,查看切片和高贡献特征。来源分类 AUC 高只说明可区分:先删除 ID、批次号、导出时间再复测。若剩余差异是新渠道,多做该渠道的切片验证;不要仅凭 AUC 就删掉业务有效特征。
03|反证比漂亮相关图有用
把字段加上「事件发生时间、入仓时间、预测时是否可取」。例如退款完成时间、结案结果和人工事后标记属于未来信息;即使记录写着较早的业务时间,实际在 t₀ 后入仓也不能用。对异常强的单特征跑三组:原始、移除可疑列、在训练折内打乱标签后重训。打乱仍显著高于机会水平,优先审计预处理、重复实体、缓存和评估代码;接近机会水平也不能证明没有泄漏。
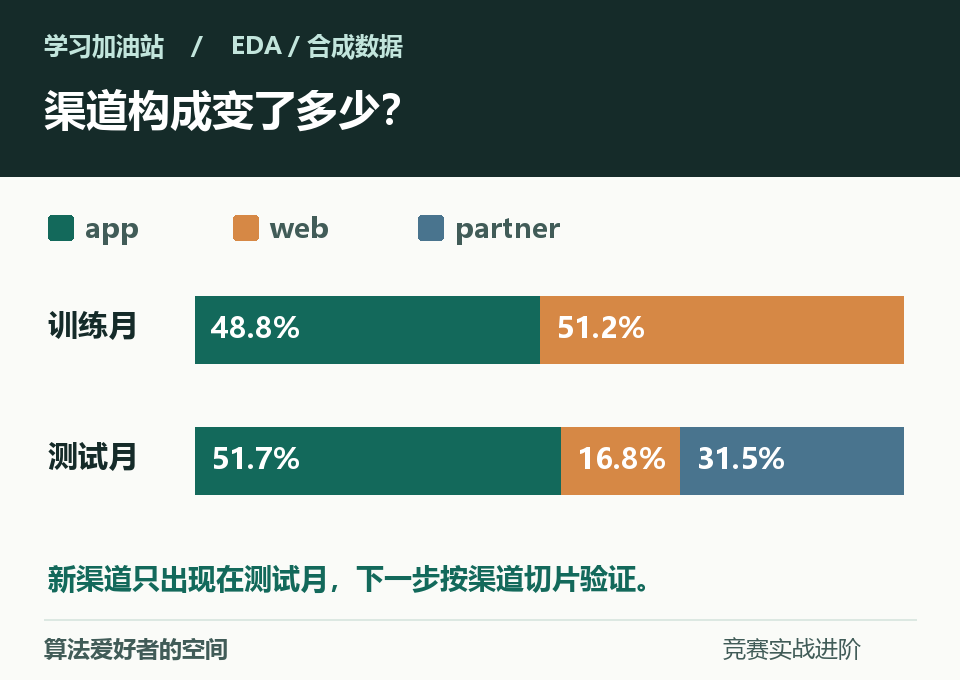
实例|图二的合成数据里,测试月出现 31.5% 的新渠道,全局金额缺失率从 5.5% 升至 12.0%。这两个现象可能由同一渠道变化驱动。下一步先分别计算渠道内缺失率,再决定补缺策略或增加渠道切片;直接对全量拟合一套新规则会把现象和原因混在一起。
练习|运行附件,定位被植入的渠道变化、未知类别和事后字段。写三行实验卡:证据是什么、如何证伪、如果成立下一步怎么改。只有可复验的发现才进入特征清单。