Agent · 微调
10|Agent 微调:从 SFT/LoRA 数据到上线验收
判断什么时候该微调而非改工具;检查 chat template、标签掩码和训练轨迹,用执行分数验收 adapter。
章节 · 工具可靠性与微调
登录后可保存进度和领取学习积分。
目标:确定该不该微调,以及怎样证明微调改善了 Agent 的可执行行为。LoRA 以低秩增量适配模型,能降低可训练参数量;它不能修复工具权限、过期知识或不可靠的评测环境。
01|先明确要学什么
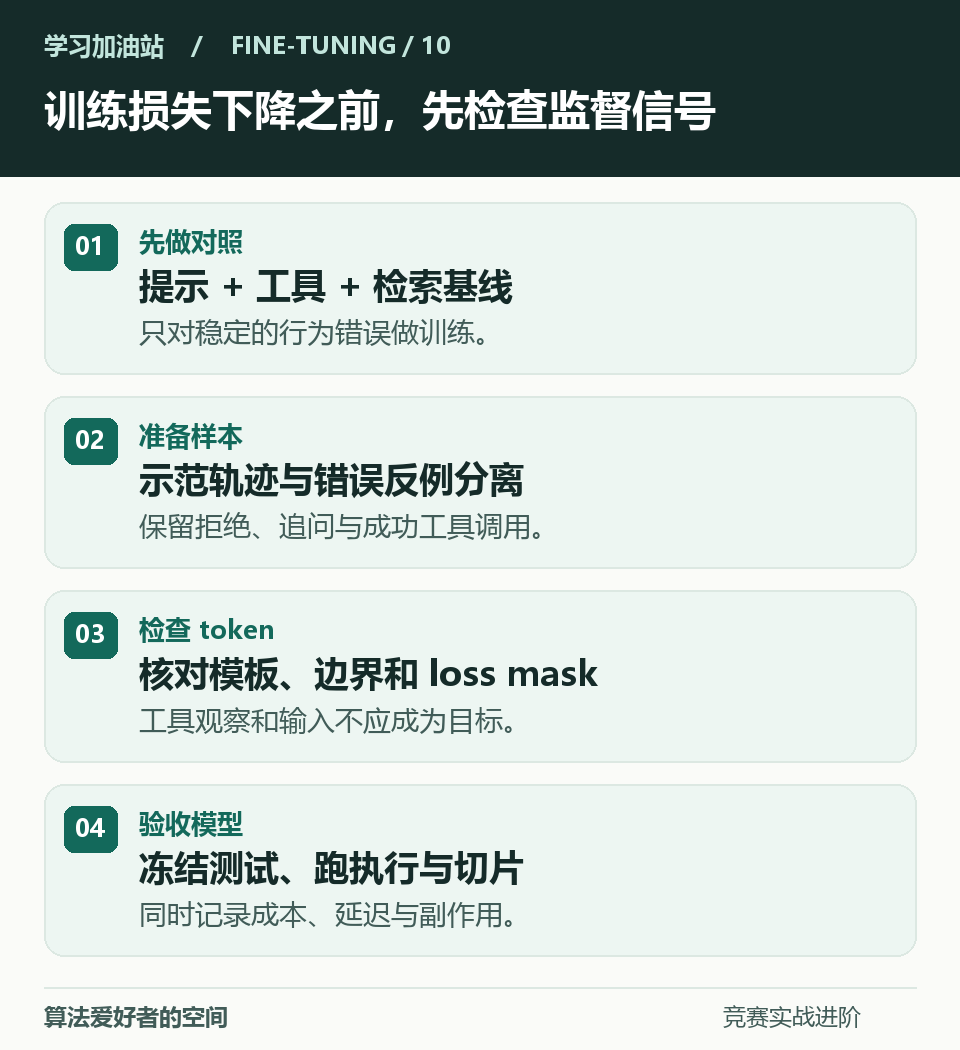
若失败来自缺知识,先改检索;若来自不可用工具或契约不明确,先改执行层;若固定提示和正确工具下仍持续选错调用、混淆参数或停止时机,才收集 SFT 示例。分层保留正例、无需工具、澄清、拒绝和恢复。工具失败记录可用于诊断或偏好数据,不能原样作为成功示范。按第 07 节的家族切分冻结测试集。
02|把「文本看起来对」落到 token
用目标模型 tokenizer 的 chat template 生成 system/user/assistant/tool 消息。用 assistant-only 或 completion-only loss 时,逐个检查标签掩码:工具观察、用户输入和 padding 应忽略;需要模型生成的工具名、参数、结构标记与终止标记应按模板被监督。assistant_only_loss 是否可用取决于模板是否能提供 generation mask。截断要成对检查工具调用和返回;若截断把目标全切没了,应跳过或重构样本。packing 时确认样本之间没有不期望的注意力或标签串联。
03|小实验与独立验收
冻结基座版本、模板、数据哈希和解码配置,先在小批样本验证梯度和标签计数。把 rank 8/16 作为可比较起点而非默认最优,同时记录目标模块、alpha、学习率、有效 token 批量和评估频率。比较提示基线、SFT adapter、必要时同模型去 adapter。选择 checkpoint 看冻结开发集上的工具选择、执行成功、额外写入、长轨迹与无工具切片;最终测试只做一次报告。训练 loss 下降但多步执行退化,先回看样本和掩码,不直接扩大训练轮次。
练习|附件是小型角色段掩码审计,演示误把工具观察纳入 loss 和截断吞掉目标的检测。脚本末尾附 TRL + PEFT 配方,写清训练/开发 JSONL、assistant-only loss、LoRA 目标层、梯度累积和保存 adapter 的配置。默认运行只做掩码审计;真实训练需要准备本地基座、训练数据与算力。相关链接可核对当前模板要求。