表格竞赛 · 模型
04|模型选型:同预算比较 GBDT、线性与神经模型
根据任务结构和评分选 baseline,再用同一验证、相近预算和切片结果判断何时值得换模型。
章节 · 建模与交付
登录后可保存进度和领取学习积分。
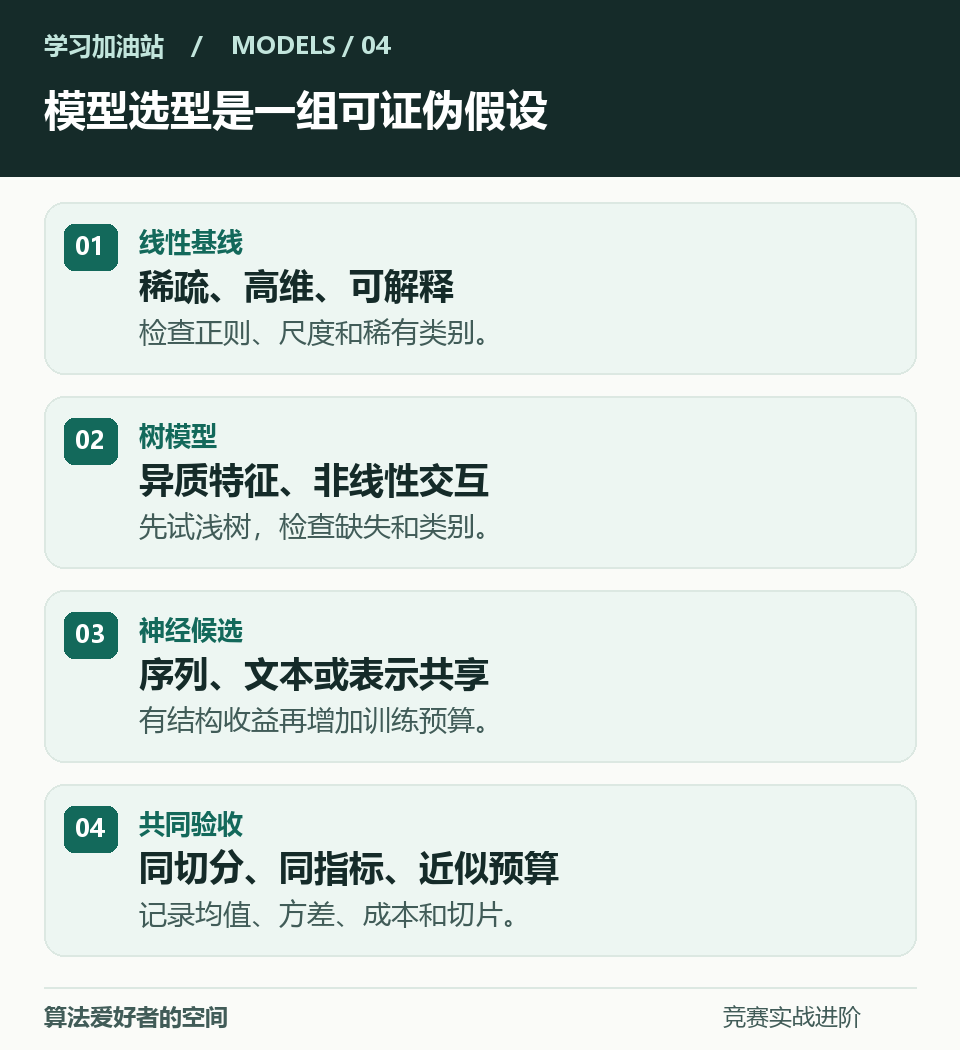
目标:用有限算力选出一套主模型和一套互补候选,而不是按榜单名称选算法。典型表格任务中,树模型常是强基线;序列、文本、多任务共享表示能改变比较条件,结论应来自本赛题。
01|用任务结构提出三个候选
稀疏高维类别或词袋先上带正则的线性模型。数值与类别混合、存在明显阈值交互时,比较 LightGBM/XGBoost 与适合原生类别处理的 CatBoost。大量事件序列或文本时,先试固定 embedding 加树,再和端到端模型比较。小样本或强漂移时,重点看浅树、强正则和简单特征的稳定性,不让复杂模型只赢随机切分。
02|控制预算和评价口径
统一 split、评估指标、可见特征与固定的试验预算,例如每类 20 次试验或 2 GPU 小时。记录模型和预处理时间、峰值内存、推理速度。早停在内层验证,外层只评估已确定方案;也可先在固定开发折筛参数,再用冻结的未来保留集做一次比较。AUC 看排序,LogLoss 看概率;正例稀少时报告 PR-AUC 及业务召回范围。回归按官方损失选择中心量:平方损失偏向条件均值,绝对损失偏向条件中位数。不要把 log 变换后的 RMSE 当作原尺度 RMSE。
03|把落后模型变成证据
每模型导出相同 row_id 的 OOF 概率。对低频类别、新用户、缺失重和时间末端报告分数和样本量。模型均值略差但在重要切片补足主模型,才值得融合;若错误高度重合,更多候选只增加调参自由度。用学习曲线区分数据不够与模型不够:训练集扩张后验证收益仍增加,应优先做更可靠的数据,而非反复微调深度。
实例|一次合成数据运行中,浅树和直方图 GBDT 的保留集 AUC 分别为 0.909 和 0.910,近乎相同;浅树的 LogLoss 却是 0.297,低于 GBDT 的 0.326。若官方考概率、且这个差异在重复切分里仍在,应保留浅树作为主候选。这里的数据特意包含阈值交互,不能把结论外推为浅树普遍更好。
练习|附件在共享切分上对照线性模型、浅树与 GBDT。按需安装 scikit-learn,命令写在脚本顶部;正式比赛把切分替换成第 02 节的验证合同。